Termina el curso, sale la encuesta, y el lunes aparece en el reporte: 4,2 sobre 5. Alguien dice que está muy bien. Alguien pregunta cuánto sacó el trimestre pasado. Y ahí se acaba la conversación, porque con un 4,2 no se puede decidir absolutamente nada: no dice qué arreglar, no dice a quién perdiste, y ni siquiera dice si fue mejor o peor que la vez anterior.
Este artículo va de cómo construir esa encuesta para que la siguiente vez sí te diga algo. Y la encuesta ya está hecha: descargar la plantilla (Excel, gratis, editable, sin registro). Trae diez enunciados redactados, una hoja de vaciado que calcula sola lo que hay que mirar, y una tercera con las seis decisiones para construir la tuya.
Una escala de Likert es un instrumento para medir una actitud o una percepción: la persona lee una afirmación y marca su grado de acuerdo entre varias opciones ordenadas, normalmente cinco. Se usa para saber qué opina alguien de algo que acaba de vivir — un curso, un servicio, una sesión — cuando esa opinión no se puede observar desde fuera.
Aquí hay una confusión que parece de vocabulario y no lo es: decide qué tienes derecho a calcular después.
Lo que todo el mundo llama «una escala de Likert» — una pregunta con cinco opciones de acuerdo — es, en rigor, un ítem de Likert. La escala que Likert definió es otra cosa: varios ítems que miden lo mismo y cuyas respuestas se suman en una sola puntuación por persona.
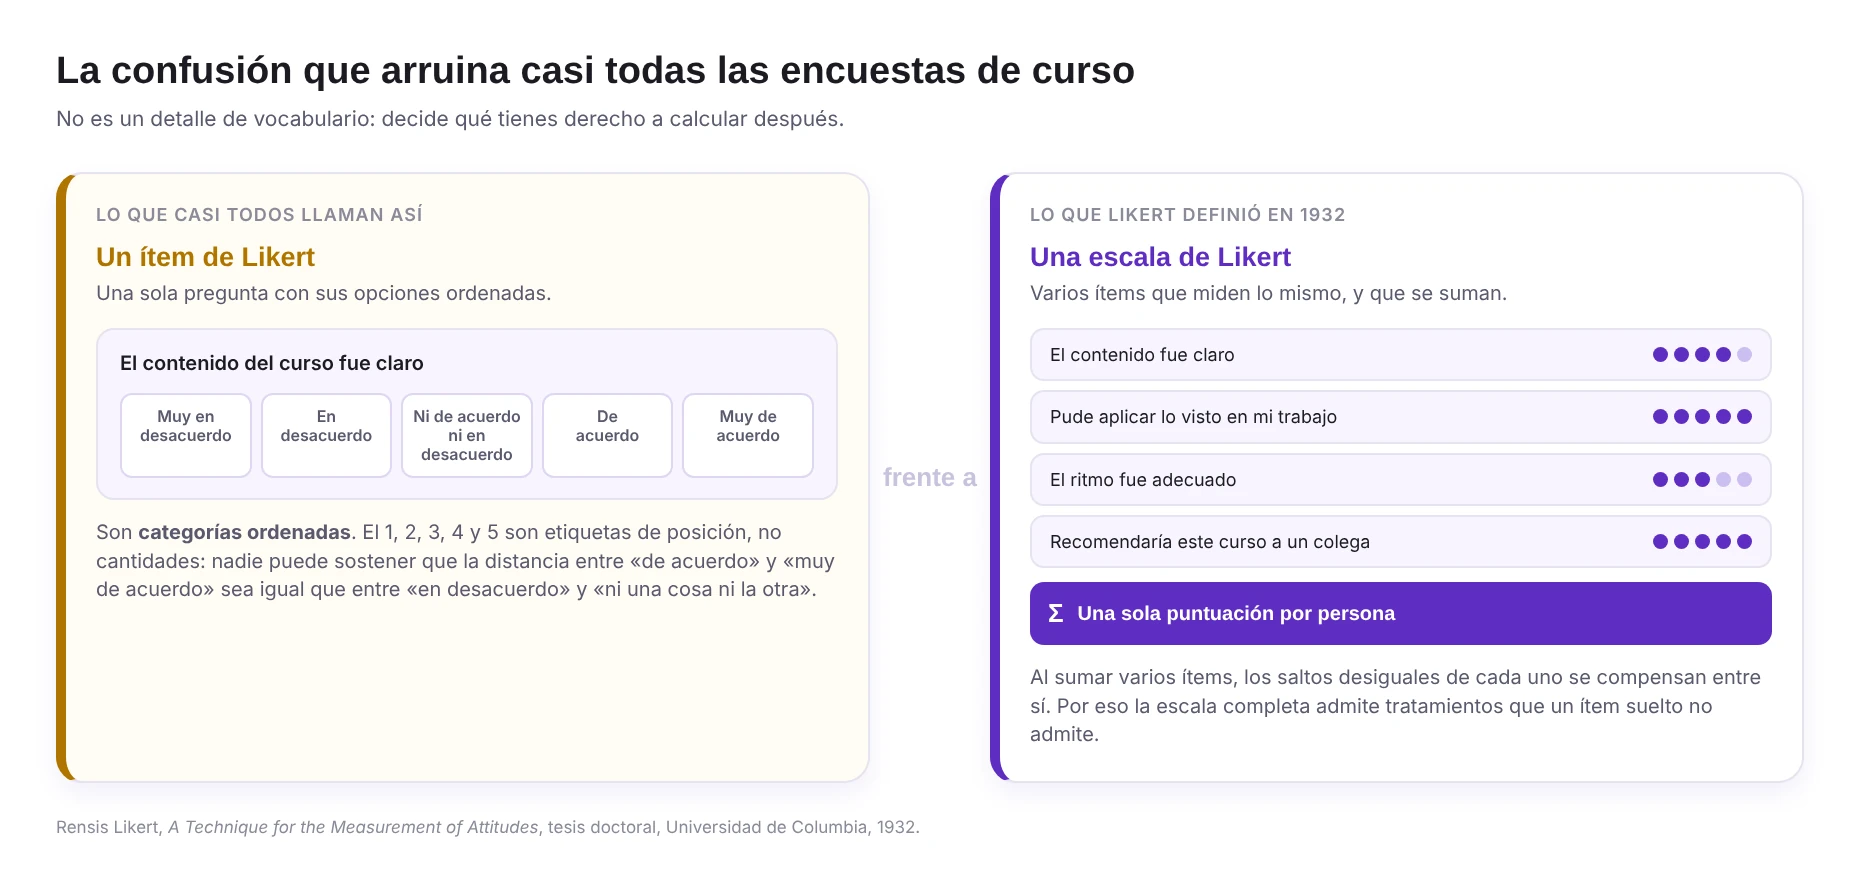
La diferencia importa por una razón concreta. En un ítem suelto, el 1, el 2, el 3, el 4 y el 5 son categorías ordenadas, no cantidades. Nadie puede sostener que la distancia entre «de acuerdo» y «muy de acuerdo» sea la misma que entre «en desacuerdo» y «ni una cosa ni la otra». Los números son etiquetas de posición. Al sumar varios ítems, esos saltos desiguales se compensan entre sí, y por eso una escala completa admite tratamientos que una pregunta suelta no admite.
Dicho de otro modo: no es que esté mal usar una sola pregunta. Está mal usar una sola pregunta y luego tratarla como si fuera una escala entera.
La inventó Rensis Likert en 1932, en su tesis doctoral en la Universidad de Columbia. Tenía veintiocho años. El título del trabajo era Una técnica para la medición de actitudes, y la palabra que importa de ese título es técnica: no proponía una teoría nueva sobre las actitudes, proponía una forma más barata de medirlas.
Lo que existía antes, el método de Thurstone, obligaba a reunir un panel de jueces que puntuara de antemano cada afirmación para colocarla en una escala. Era laborioso y lento. Likert propuso saltarse ese paso: que cada persona marcara simplemente su grado de acuerdo del 1 al 5 y se sumara. En sus propias comparaciones, su método más simple salía incluso mejor que el complicado.
No todos lo compraron. A finales de los años treinta, Leonard Ferguson rehizo el análisis y objetó que la ventaja dependía sobre todo del número de niveles de la escala, y que las afirmaciones de Likert ya habían pasado antes por el procedimiento de Thurstone — concluía que la técnica no elimina la necesidad de un grupo de jueces. Aun así concedía lo que decidió la historia: la puntuación simple del 1 al 5 es la más práctica.
Noventa y cuatro años después seguimos usando el atajo, y seguimos arrastrando la objeción de Ferguson sin saberlo: cuando mandas una encuesta de cinco preguntas sueltas sin haber pensado ninguna, estás usando la parte barata del método y saltándote la parte que le daba el sentido.
Es la primera pregunta que hace todo el mundo y la respuesta honesta es que la evidencia está empatada. Las simulaciones favorecen el número par de opciones; los estudios con personas reales favorecen el impar. Lo que sí está claro es el rango: la fiabilidad mejora al pasar de cuatro a siete opciones, y a partir de siete la ganancia deja de notarse.
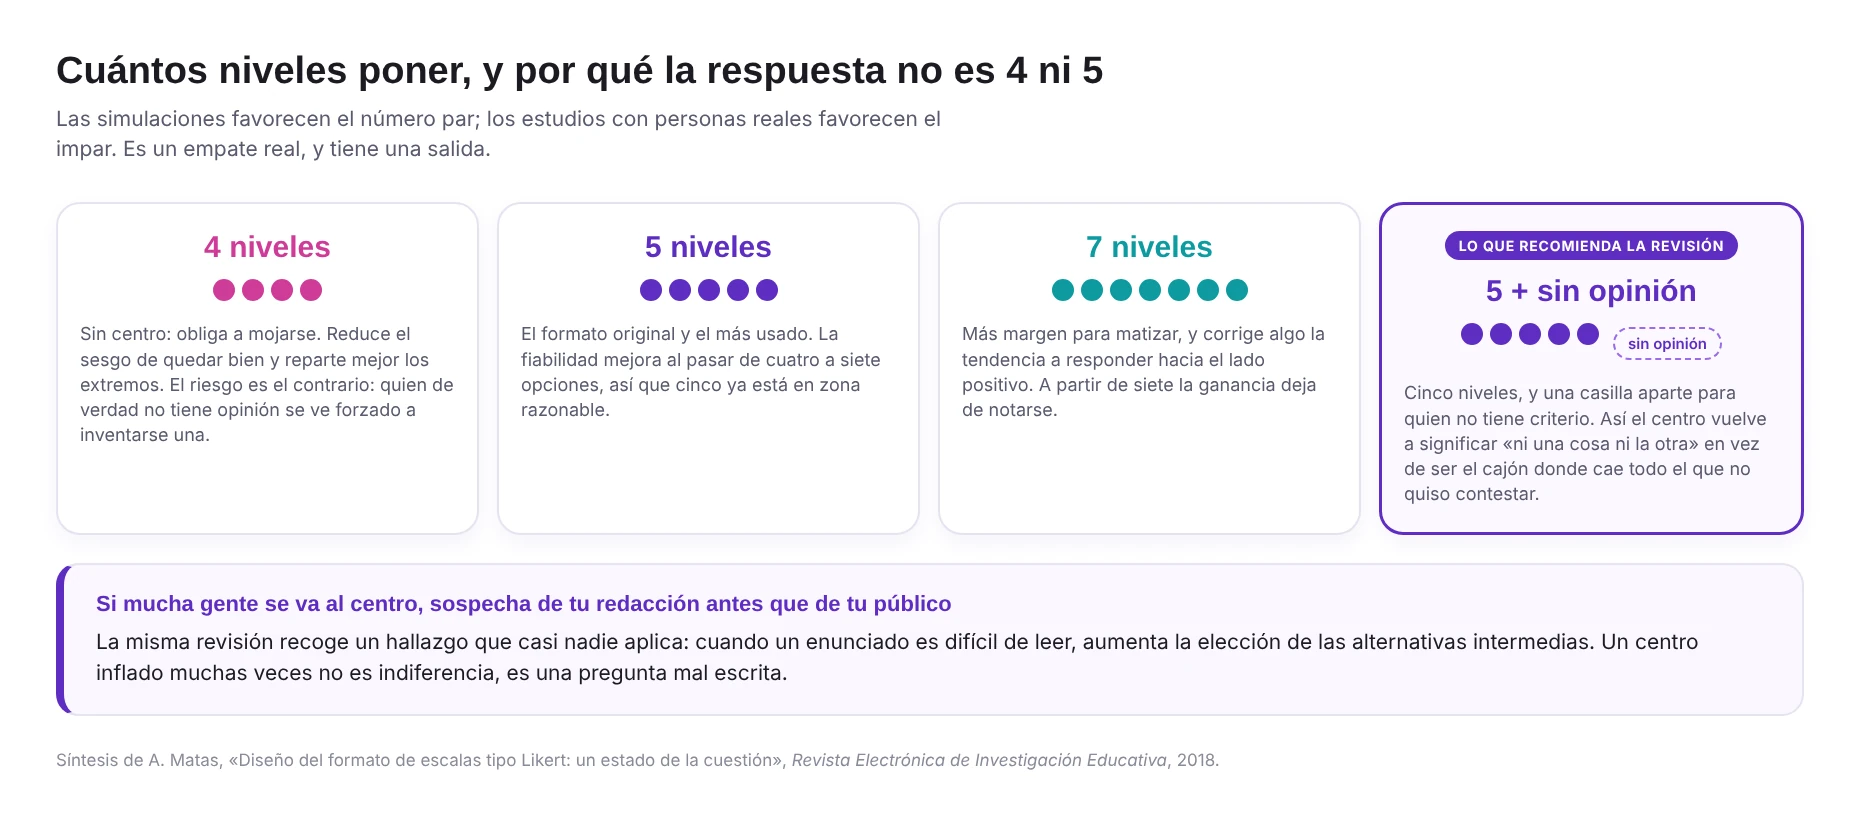
La salida al empate no es elegir entre cuatro y cinco. Es cinco niveles más una casilla de «sin opinión» separada de la escala, que es lo que recomienda la revisión más completa publicada en español sobre el diseño de estas escalas. Así no fuerzas a nadie a inventarse una postura, y a la vez el centro vuelve a significar «ni una cosa ni la otra» en vez de ser el cajón donde cae todo el que no quiso contestar.
Aquí está el dato que debería cambiar cómo lees tus propias encuestas. La casilla del centro absorbe entre el 20% y el 50% de las respuestas. Entre una de cada cinco y una de cada dos.
Esa gente no te ha dicho nada, y ocupa la mitad de tu muestra.
Quitar el centro tiene un argumento serio detrás: reduce el sesgo de quedar bien y reparte mejor las respuestas entre los extremos. Pero tiene el problema contrario, y también está documentado: forzar la elección introduce error, porque quien de verdad no tiene criterio acaba marcando algo que no piensa. Por eso la solución razonable es separar las dos cosas — indiferencia y desconocimiento — en vez de meterlas en la misma casilla.
Y hay un hallazgo más, pequeño y muy útil: cuando un enunciado es difícil de leer, aumenta la elección de las alternativas intermedias. Si en tu encuesta hay una pregunta concreta donde el centro se dispara y en las demás no, lo primero que tienes que mirar no es a tu público: es cómo escribiste esa frase.
Una sola idea por frase, en primera persona, corta y sin negaciones. Suena obvio y es donde se cae casi todo.
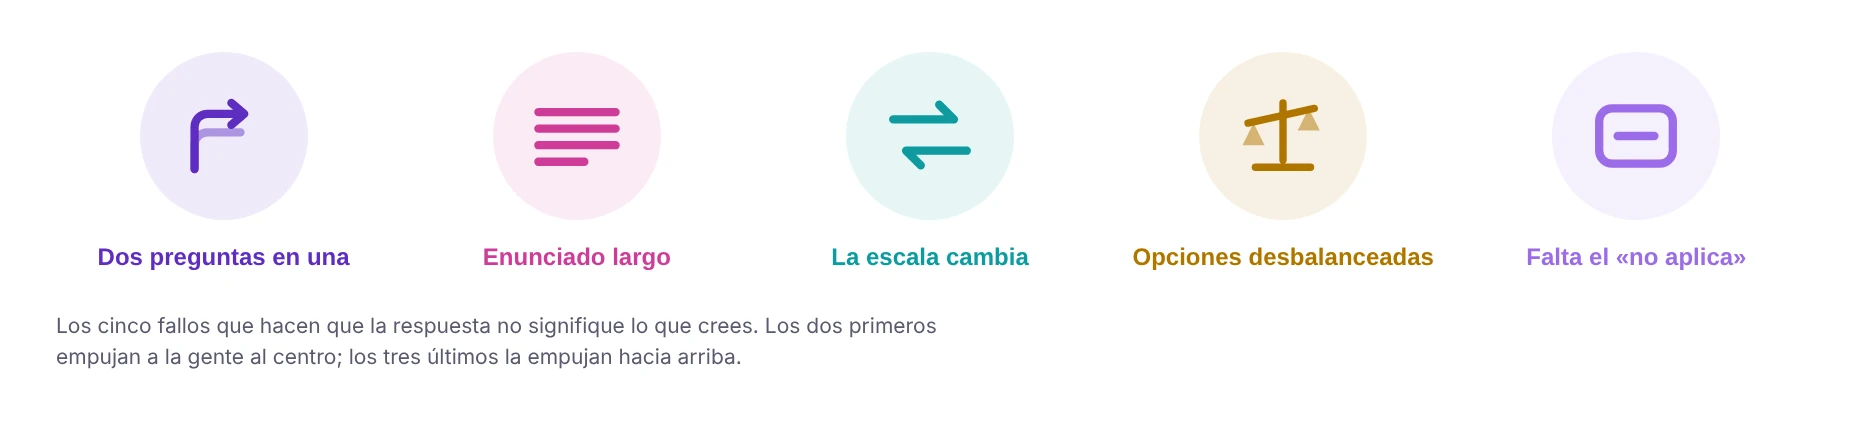
Y una regla de cantidad: entre ocho y doce enunciados para un curso. Más allá de ahí la gente empieza a marcar la misma columna hacia abajo para terminar, y esa fila de cincos no significa nada.
Volvemos al 4,2 del principio. El problema del promedio no es que sea impreciso: es que supone que los saltos entre opciones son iguales, y no lo son. Dos cursos con exactamente el mismo promedio pueden tener situaciones opuestas.
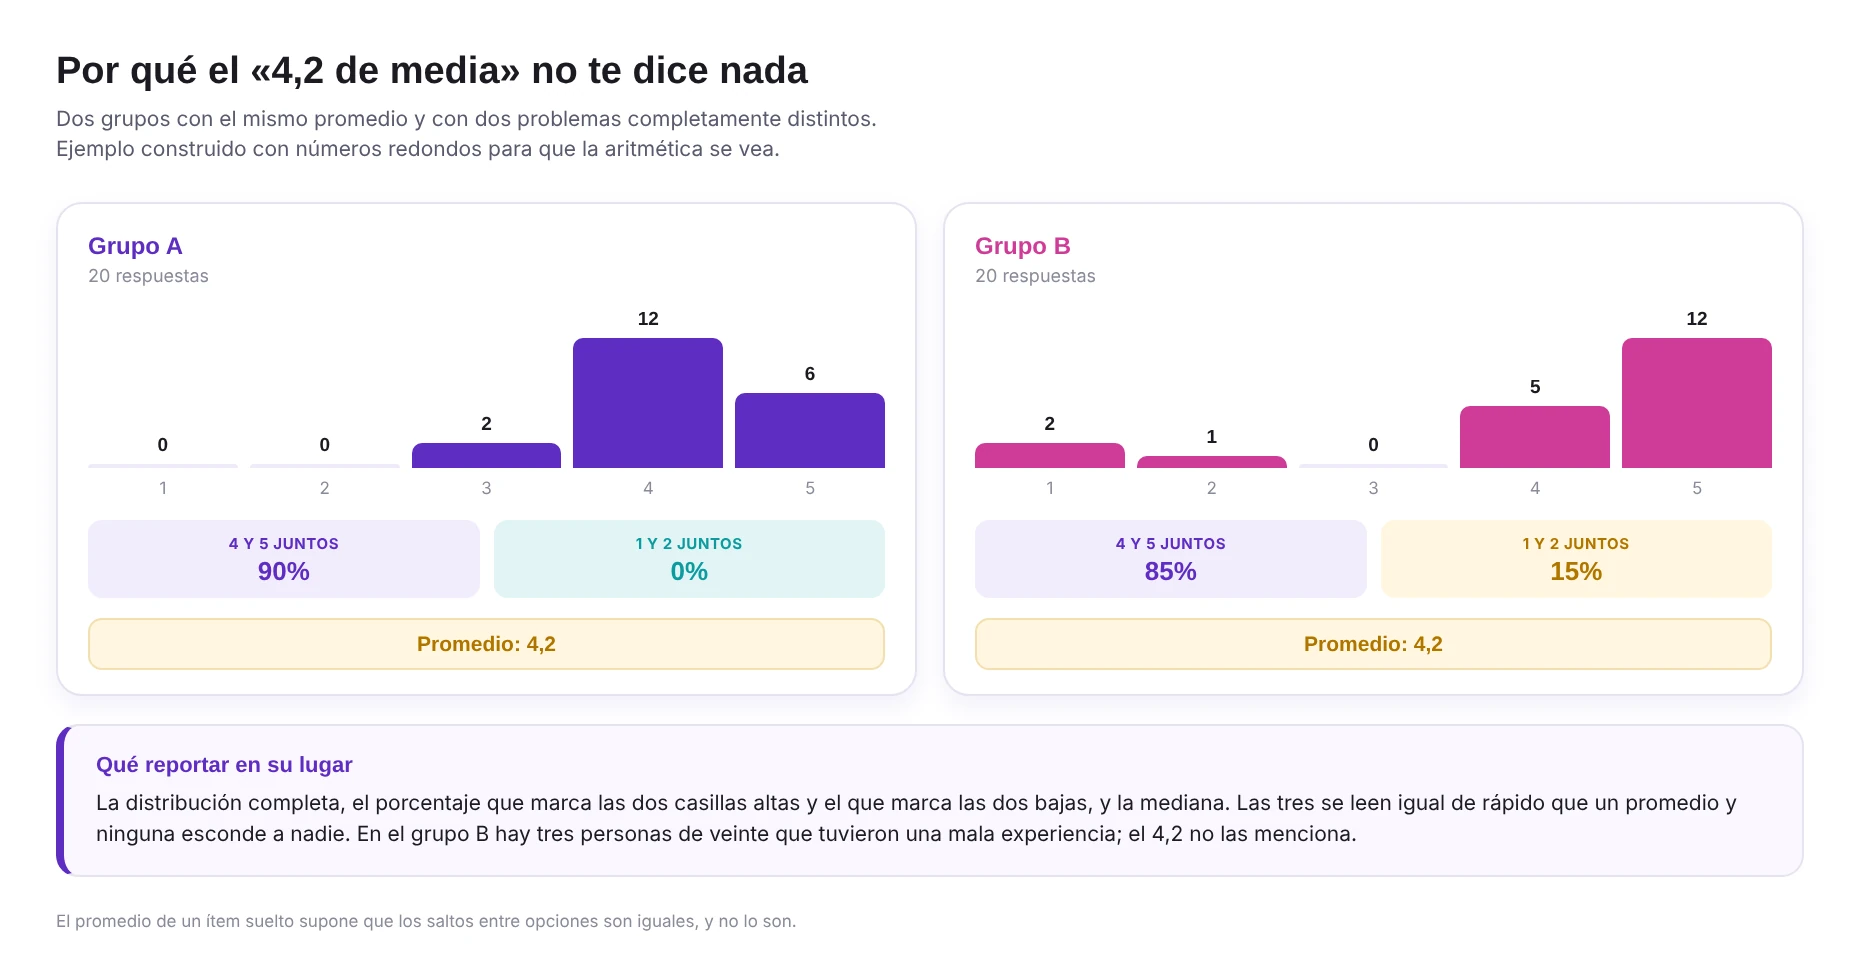
En el grupo A no hay una sola persona descontenta. En el grupo B hay tres de veinte que tuvieron una mala experiencia y probablemente no vuelvan. El 4,2 no las menciona.
Lo que sí funciona, y se lee igual de rápido:
Y la lectura más útil de todas no es comparar cursos: es comparar enunciados dentro del mismo curso. Qué pregunta salió peor te dice exactamente qué arreglar. Comparar el total contra el del trimestre pasado solo vale si la encuesta fue idéntica, cosa que casi nunca ocurre.
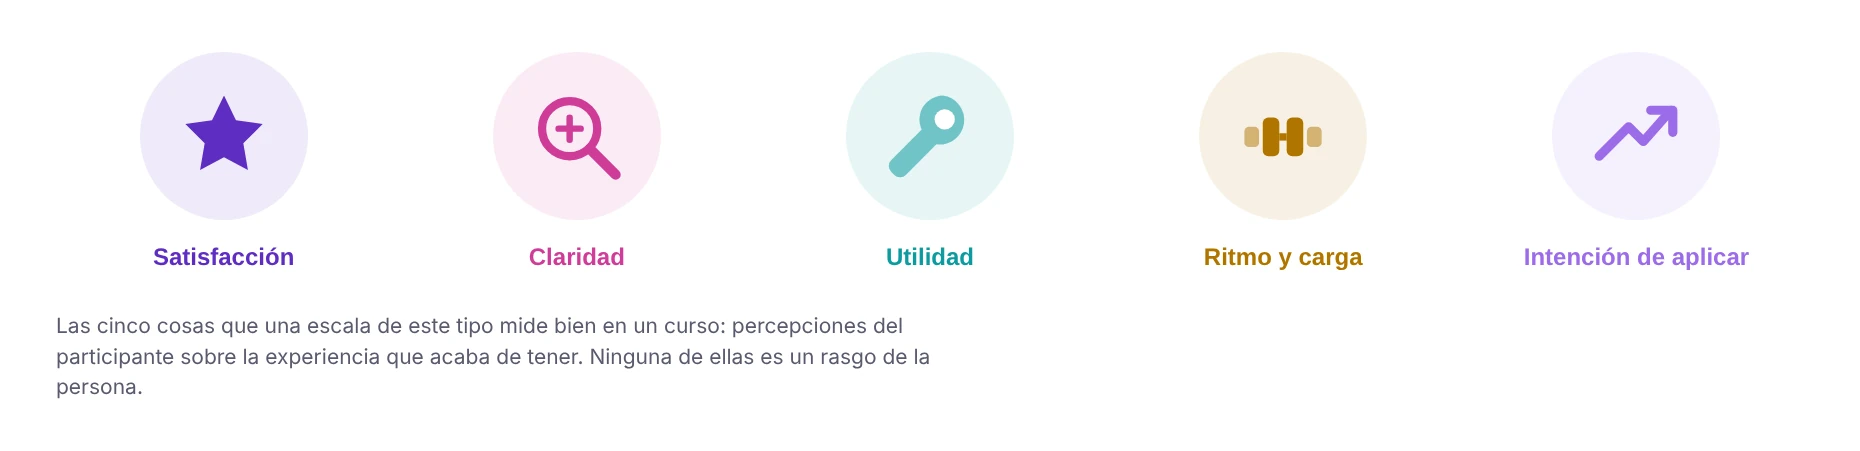
Cinco dimensiones cubren bien un curso. Estos son enunciados reales de la plantilla, ya redactados con las reglas de arriba.
No quites las dos preguntas abiertas del final — qué fue lo más útil, y qué una sola cosa cambiarías. Suelen dar más material accionable que las diez escalas juntas, porque es donde aparece lo que no se te ocurrió preguntar.
Conviene decirlo claro, porque es la confusión más cara de este tema. Todo lo anterior sirve para medir una experiencia: un curso, una sesión, un material. Percepciones de quien acaba de pasar por ahí.
No sirve para medir cómo es una persona. Construir un instrumento que mida rasgos psicológicos es otro oficio: lleva jueces, pruebas piloto, análisis de ítems y comprobaciones de fiabilidad, y existe un procedimiento académico entero para hacerlo. Una plantilla de encuesta no es eso, y usarla como si lo fuera para evaluar gente es tomar decisiones sobre personas con un instrumento que no las aguanta.
Hay además una distinción práctica que vale la pena tener a mano: una escala de este tipo pregunta; una escala conductual observa. Si lo que quieres saber es si alguien mejoró una habilidad, preguntarle si cree que mejoró no te lo va a decir — eso se mira con conductas descritas y dos observadores, que es el método explicado en cómo entrenar y medir habilidades blandas.
Donde ayuda. Revisar tus enunciados uno por uno buscando los cinco fallos de arriba: detecta muy bien la pregunta doble y la frase larga, que son los dos más comunes. Reescribir un enunciado en tres versiones más cortas para que elijas. Y agrupar cientos de respuestas abiertas en temas, que es el trabajo que hace que la gente deje de poner preguntas abiertas.
Donde no. No puede decidir qué vas a hacer con el resultado, que es la única decisión que hace que la encuesta valga la pena. No puede inventarte respuestas para rellenar una muestra pequeña. Y no debe interpretar sola una distribución baja: cuando un enunciado sale mal, lo que hay que hacer es leer las respuestas abiertas de esas personas, no pedir un resumen.
Una encuesta al cerrar el curso llega tarde para arreglar ese curso. Sirve para el siguiente. Si lo que quieres es corregir mientras el programa todavía está vivo, la medición tiene que ocurrir durante, y eso es otra cosa: está en evaluación formativa, los tres momentos y la rúbrica.
La segunda pregunta es qué instrumento usar para cada cosa. Una escala mide percepción; un quiz mide conocimiento; una simulación mide desempeño. Confundirlos es el error que hace que un programa parezca exitoso sin serlo, y la comparación está en evaluación en e-learning: quiz, simulaciones y exámenes.
Y si lo que tienes delante es una evaluación de personas y no de cursos, el formato es distinto y tiene su propia plantilla en formato de evaluación de desempeño. Por último, el salto de «la encuesta salió bien» a «el negocio mejoró» necesita su propio razonamiento, y está en cómo medir resultados y retorno de la capacitación.
Es una técnica para medir actitudes y percepciones: la persona lee una afirmación y marca su grado de acuerdo entre varias opciones ordenadas. Sirve para saber qué opina alguien de algo que vivió — un curso, un servicio, una experiencia — cuando esa opinión no se puede observar desde fuera. La creó Rensis Likert en 1932 en su tesis doctoral.
Es la versión más usada: cinco opciones que van de «muy en desacuerdo» a «muy de acuerdo», con un punto neutro en el centro. Los números del 1 al 5 son etiquetas de posición, no cantidades, así que no se puede dar por hecho que la distancia entre el 4 y el 5 sea la misma que entre el 2 y el 3.
Es la misma mecánica aplicada a satisfacción: cinco niveles de más insatisfecho a más satisfecho. Para que sirva, el enunciado tiene que ser una afirmación concreta sobre algo que la persona acaba de vivir, no una pregunta general del tipo «¿qué tan satisfecho estás?», que mezcla todo en una sola respuesta y no se puede accionar.
Es la versión sin punto medio: obliga a inclinarse hacia un lado. Su ventaja es que elimina el cajón central, que se lleva entre el 20% y el 50% de las respuestas. Su desventaja es que fuerza a responder a quien de verdad no tiene opinión, y eso introduce error. La alternativa más limpia es mantener cinco niveles y añadir una casilla de «sin opinión» fuera de la escala.
De una sola pregunta, no deberías: el promedio supone que los saltos entre opciones son iguales y no lo son. Reporta la distribución, el porcentaje en las dos casillas altas y en las dos bajas, o la mediana. Una escala completa de varios ítems sumados admite más tratamientos, pero requiere haberla construido como tal.
Entre ocho y doce enunciados de escala, más dos preguntas abiertas. Por encima de esa cantidad aparece el patrón de marcar la misma columna hacia abajo para terminar antes, y esas respuestas contaminan el resultado sin que puedas distinguirlas.
Las dos formas circulan y se entienden igual. Likert va siempre con mayúscula porque es un apellido, el de Rensis Likert, y se pronuncia líkert, con el acento en la primera sílaba.
Redactar los enunciados y decidir qué vas a hacer con el resultado es trabajo de papel. Lo demás vive en la plataforma: la encuesta enganchada al final del curso para que no haya que perseguir a nadie, las respuestas recogidas por persona y por grupo, el histórico que permite ver si el mismo enunciado mejora de una edición a la siguiente, y la distribución a la vista en vez de un promedio. Sabionet es una plataforma SaaS que cubre ese tramo — contenido, rutas, entregas, rúbricas, grupos y reportes por persona — con tu marca y tu dominio.
Puedes crear tu academia y probarla gratis, o agendar una llamada y revisamos juntos los enunciados de tu encuesta actual.